Нейросети сейчас есть почти у всех. Но обычная нейросеть знает только то, что вы сами ей загрузили. RAG-система подключает её ко всем знаниям компании: к 1С, CRM, документам, почте. Мы поговорили с Максимом Орловым, основателем студии Do Digital, о том, как устроена такая система, кому она нужна, сколько стоит и на что смотреть собственнику до старта.
Справка. RAG (Retrieval-Augmented Generation) — технология, при которой нейросеть, прежде чем ответить, находит нужную информацию в базе знаний компании и отвечает на её основе.
Что такое RAG-система и какую бизнес-задачу она решает?
RAG-система — это система, которая объединяет все знания компании в одну единую базу, с которой может работать нейросеть. Её можно интегрировать со всеми источниками данных, которые есть у компании: с сайтом, системой учёта, 1С, 1С:ERP, трекерами, Яндекс Облаком, Google Документами, Яндекс Документами. В принципе, с любой системой — как с открытым API, так и без него. Мы загружаем в нейросеть всю имеющуюся информацию и пишем для неё инструкции, которые помогают понять контекст, в котором находится компания, и какую деятельность она ведёт.
Если чуть подробнее, есть данные разных уровней: данные о самой компании и данные, с которыми компания работает. Это отдел продаж, план продаж, документация, которая крутится внутри отдела, потом отдел маркетинга, иногда небольшой отдел разработки, обычно есть тот, кто заведует 1С.
Все эти отделы шаг за шагом, этап за этапом можно интегрировать в такую систему. RAG-база получает данные по интеграциям из разных источников, а нейросеть знает, как работает компания. Она работает с документацией и знаниями компании, у неё есть контекст. Она понимает, условно, какой столбик в 1С за какой параметр отвечает и какие данные хранит, и может работать с этими данными.
Когда компании нужен RAG, а когда достаточно обычной нейросети?
Обычная LLM есть у всех. Но она имеет доступ только к той информации, которую вы отправляете ей в интерфейсе. Если вы пользуетесь нейросетью по подписке или через какой-то шлюз, вы можете закидывать ей контекст и данные вручную — и она знает только то, что вы ей «скормили». Что загрузил, о том и поговорил.
RAG-база подключена непосредственно к базе знаний компании и ориентируется в ней. Новые данные поступают туда без того, чтобы вы что-то вносили руками. То есть вы получаете доступ ко всей системе, которая знает о компании всё.
По такой базе можно задавать вопросы о компании, в том числе узкие, специализированные, в разрезе конкретных метрик. Например, отдел продаж ищет специфические показатели. Или компания продаёт технику и запчасти к ней, и нужно посмотреть коэффициенты соотношения одного к другому, как меняются объёмы производства и продаж. Если специализированные дашборды не настроены, можно нажать одну кнопку, сказать голосом или написать, что нужно, — и система сама соберёт в интерфейсе нужный набор дашбордов и объяснит, что они показывают.
Получается, такая система подойдёт всем, у кого есть корпоративная информация?
Да, абсолютно верно. Она полезна там, где есть систематическая бизнес-деятельность, есть бизнес-юниты, накапливается объём информации и эта информация обновляется. Если компания живая — ей нужна такая система.
Я бы ещё добавил то, что постоянно говорю всем: ваш ассистент, который работает на базе RAG, — это полноценный новый сотрудник вашей компании. А любой сотрудник должен в моменте знать, что происходит в компании в рамках своих должностных полномочий и своего участка работы, и иметь доступ к актуальной информации.
Какие задачи чаще всего решают с помощью RAG-системы?
В основном это направления, связанные с продажами, маркетингом, дистрибуцией, а также специфические вопросы руководителя бизнеса. К директору стекается вся информация по компании, и он может делать свои собственные выборки.
Вообще с системой может работать вся иерархия компании, все её отделы. Даже внутри продаж бывают отдельные направления: например, продажи через дилеров — это отдельное направление, обучение дилеров — тоже отдельное. У компании разные виды деятельности, и под каждую из них можно получать обратную связь в этом интерфейсе.
Из чего состоит RAG-система на практике?
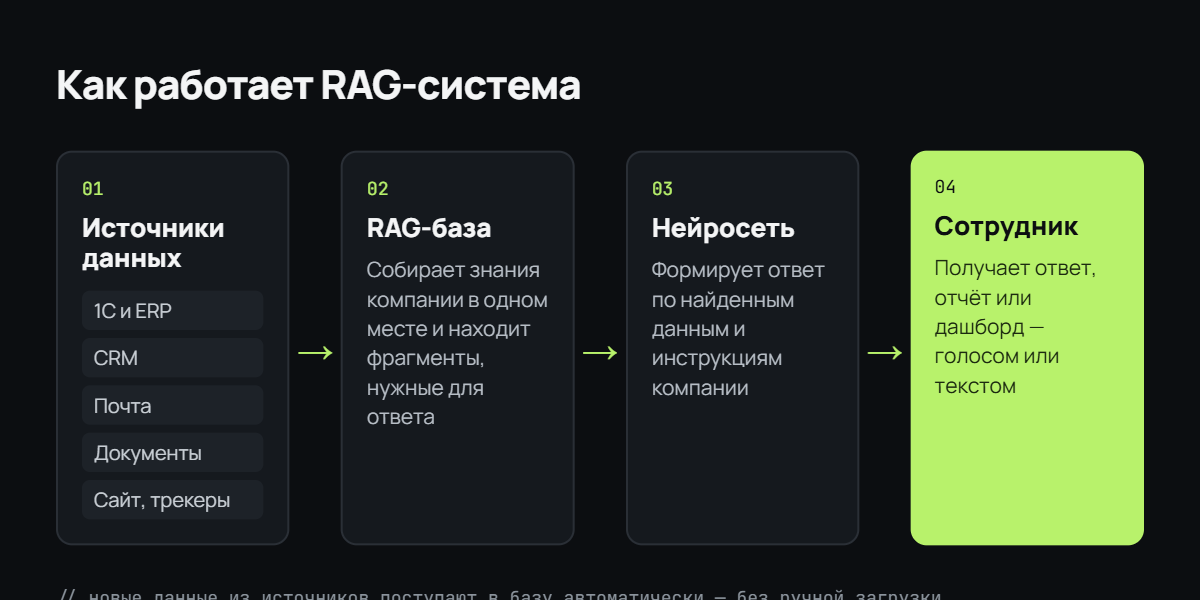
Это несколько блоков:
- блок интеграций;
- сервер и база данных;
- шлюз — туннель, через который в систему подключается модуль нейросети;
- фронтенд — интерфейсный блок, с которым работает пользователь. Он видит поле для ввода сообщения.
Дальше, в зависимости от задач компании, нейросети можно дать шаблоны, чтобы при определённых запросах она собирала нужные наборы информации в определённом виде — например, в виде дашбордов.
Какие данные можно подключить: почту, документы, CRM?
Подключать можно все данные — и желательно подключать все. Если есть возможность подключить почту, мы подключаем почту. При этом мы настаиваем на том, чтобы идти поступательно, шаг за шагом, подключая источники один за другим. Но подключать всё.
Как система понимает, где искать нужную информацию?
Например, сидит менеджер отдела продаж и что-то запрашивает. Как система понимает, где искать? Для неё прописывается инструкция, сценарий?
Хороший вопрос, и ответ на него простой. Мы берём данные клиента — структурированные или неструктурированные. И здесь в силу вступает то, о чём я говорил в начале: настройка под компанию. Саму нейросеть мы не переобучаем — мы подключаем к ней данные и даём ей инструкции. Когда сотрудник задаёт вопрос, система сначала находит в базе подходящие фрагменты — документы, записи, строки таблиц, — и только потом нейросеть формирует ответ на их основе. А чтобы она правильно понимала найденное, в начале работы RAG-системы мы её настраиваем.
Мы объясняем нейросети, что значат выгрузки и поля, что значат условные столбики и столбцы. Скажем, в 1С есть идентификаторы, поля, выгрузки — что они означают? Мы пишем для нейросети определённый свод правил, если хотите, такую азбуку: что есть что в этой компании, чтобы она понимала, какие данные получает. Где-то хватит просто названия столбика, а где-то нужно объяснить, как эти данные получаются.
И самое главное — объяснить, в результате каких действий компании эти данные накапливаются. Допустим, у завода есть линия производства, значит, есть переналадка, есть сотрудники, есть циклы. Эти данные частично могут быть в 1С или других системах, а могут и отсутствовать. Сколько времени уходит на одни действия, сколько на другие, что значит, когда приходят одни данные и когда другие, сколько требуется людей — всё это нужно объяснить.
Какие ошибки чаще всего допускают при разработке таких систем?
Я бы выделил несколько сложностей.
Первая — пытаются сделать всё сразу, и это даёт ровно обратный эффект. Если всё сразу, потом всё равно приходится возвращаться к настройке и сегментировать. Получается куча мала: ты всё скинул туда и думаешь, что оно само разберётся. В итоге система вроде бы работает, но непонятно, как ею пользоваться. Её запускают везде и сразу для всех. Нет постепенного раскрытия системы на отдельных отделах, чтобы понять, какие метрики были до и после и как она работает, — и уже потом перенести её на другие участки компании и замкнуть внутри своего контура.
Вторая — риски утечки данных. Если компания использует открытые нейросети, например Claude, ChatGPT и так далее, там есть особые условия работы с данными. Сотрудники могут вносить личную информацию, и она может попадать в выдачу нейросети. Поэтому мы можем ставить специальный модуль, который обезличивает данные в процессе работы.
Третья — интеграция и подключение данных. Здесь очень важно проговорить то, что я повторяю много раз: какие данные откуда поступают, что это за данные, как они получаются, как клиент к ним приходит — чтобы модель понимала эти данные досконально. Здесь большие риски: клиенты обычно оставляют это на внутреннее взаимодействие, машут рукой — «а, это кто-то из наших сделает» или «это само собой получится». Но это даже важнее, чем обсуждение любого другого момента — что мы хотим от этой базы, что там должно быть. Всё это неважно, если нет точного понимания по данным.
Если нет понимания по данным — выгрузка или не выгрузка, интеграция или не интеграция, — всё остальное становится неважным. Я хочу, чтобы это было понятно и донесено, потому что все спрашивают одно и то же: какая главная проблема? Главная проблема — выгрузка данных.
Бывает ли, что RAG-система ошибается, даже если нужная информация есть в базе?
Как клиенту проверить, что система отвечает правильно? И сколько на это нужно времени?
Это этап доводки — когда ты уже делаешь мелкие настройки инструкций, поиска и подготовки данных. Если говорить про математику, там математика правильная. А если про несовершенство ответов — что система может повторять не то, что нужно, или собирать отчёты и вставлять туда неправильные данные, — это всё доводится, это всё исправляется уточнением инструкций и данных. Ждать, что она заработает моментально, можно, но обычно требуется небольшая доводка в районе месяца, чтобы вместе с участниками процесса, с держателями результата увидеть это и что-то поднастроить.
— То есть клиент вместе с вами после запуска проверяет ответы?
Да, это тестирование. Но вообще такие системы работают довольно надёжно. Может быть даже такая проблема: разработчик обновит модель, и она начнёт отвечать чуть-чуть с другим акцентом. Но и это решаемо: мы можем внедрять системы, на моделях с зафиксированной версией, которая не меняется без вашего ведома. Это модели с зафиксированными весами — ты к ним обращаешься и понимаешь, что неожиданного ответа не будет, нейросеть будет работать именно так, как устроена.
Что важнее для хорошей системы: модель, данные или архитектура?
Важно всё. Модели, конечно, отличаются по своей специфике: кто-то больше завязан на контекст, кто-то на математику, кто-то на биологию и так далее. Архитектура тоже важна, но она простая: если совсем упрощённо, мы собираем данные, настраиваем поиск и инструкции и тестируем ответы. Но самое важное — это данные.
Сколько занимает разработка и внедрение?
Обычно 5–6 недель, то есть полтора месяца. Около двух недель мы пишем техническое задание: проводим две встречи с командами заказчика, утверждаем перечень и спецификацию выгрузок, уточняем, какое поведение система должна показывать, снимаем метрики, которые потом покажут успешность пилота. Мы определяем, кто будет хозяином результата и с кем можно будет дотачивать этот результат, — чтобы на всех позициях у нас был человек или цифра.
Из чего складывается стоимость?
Стоимость складывается из трудозатрат — человеко-часов. Обычно это шесть недель кропотливой работы двух специалистов.
Аудит — от 180 тысяч рублей, пилот — от 350 тысяч. Это минимальные суммы, обычно проект выходит в полмиллиона — 600–700 тысяч. Как правило, мы начинаем с одного отдела, а потом за сумму в разы меньше переносим систему на другие отделы.
Хотите понять, сколько будет стоить RAG-система для вашей компании? Начните с аудита данных: за 1–2 недели мы составим карту источников и план пилота на одном отделе. Подробнее →
Как собственнику понять, окупится ли RAG-система?
Окупается ли 1С? Окупается ли сайт? Мы делаем их, чтобы бизнес мог быстро принимать решения, чтобы все данные были удобно собраны в одном месте и к ним был прямой доступ.
Кроме того, это возможность аналитики с помощью нейросетей, привязанной именно к вашей компании. Без лишних объяснений система чётко формулирует то, что вам нужно по вашим запросам внутри компании: сравнения, новые планы, ответы, аналитику — всё это уже есть внутри.
Что вы лично проверяете в каждом проекте?
Обычно мы говорим про данные. В каком виде лежат данные — это самое важное. Откуда мы можем их получать? Кто их заносит? Как выстроен этот процесс? Вот это самый любопытный момент.
Потому что мы, условно, продаём пустую систему, которую сначала надо наполнить, настроить и передать в работу. Поэтому меня интересует вопрос: чем её наполнить?
Что сейчас происходит с RAG-системами?
Сейчас это становится популярной системой, такие системы появляются в компаниях всё чаще. По исследованию МТС Web Services (декабрь 2025 года, более 700 российских компаний с бюджетами на ИИ), стратегия развития искусственного интеллекта есть только у 26% компаний, которые финансируют это направление. То есть у трёх из четырёх компаний деньги на нейросети есть, а стратегии их внедрения нет.
Внедрить RAG-базу — это только первая ступень использования нейросетей в своём деле. Этот модуль — must-have, обязательная вещь для компании. А дальше — как вы будете использовать свои системы применительно к конкретному бизнесу. Это только начало, точка старта. Есть примеры для блогеров, заводов, компаний с отделами продаж и маркетинга — о пяти таких примерах RAG-баз мы расскажем в отдельной статье.
Какой будет RAG-система через 2–3 года?
Начнём с простых основ: мы уже видим, что нейросети хорошо работают с данными. Дальше интеграция будет проще, станет проще работа с неструктурированными данными, появится больше возможностей собирать такой сервис под себя на базе RAG. Фундаментального переворота я не жду: это всё-таки система, которая позволяет работать со своими данными.
В итоге она может стать окном для чего-то большего — внутренней системы, которая будет и трекингом, и будет сама что-то делать. Не только аналитический модуль, но и, скажем, модуль, связанный с CRM. Возможности очень большие. Смотрите: зачем вам другие системы, если вы пользуетесь этой? Она будет генерировать вам интерфейс для CRM, интерфейс вроде админки сайта. В дальнейшем всё, что развёрнуто у компании вовне, и всё, что работает внутри, может стать единым целым, а не разрозненными базами.
Сейчас вы идёте в 1С, потом в Битрикс, в трекер, в Telegram, в какой-то мессенджер, в банк и так далее. А будет одно место, которое показывает разные интерфейсы, но работает с данными, которые туда поступают. Заносить данные будет так же просто, как вы заносите их в 1С.
Но чтобы после RAG-базы двигаться дальше, нужно смотреть на инфраструктуру. Об этом мы поговорим отдельно.
Хотите RAG-систему для своей компании?
Do Digital внедряет RAG-ассистентов под ключ: начинаем с аудита ваших данных и пилота на одном отделе, затем масштабируем на всю компанию.
Что происходит с ИИ после запуска? Читайте в интервью с техническим директором Do Digital Денисом Бенчарским: ИИ запустили — а дальше что?