Компания внедрила ИИ-ассистента или агента, всё работает, проект сдан. Можно выдохнуть? Не совсем. Модели обновляются, бизнес меняется, интеграции падают, а без присмотра даже хорошая система быстро начинает отставать. Основатель Do Digital Максим Орлов расспросил Дениса Бенчарского, технического директора и партнёра студии, о том, что происходит с ИИ после запуска: где его размещать, как защитить данные, сколько стоит содержание и какие вопросы задать подрядчику до старта.
Почему нельзя просто запустить ИИ-ассистента и забыть?
Во-первых, сам искусственный интеллект развивается очень быстро. Допустим, вы запустили агента, прошло какое-то время, и вышла новая модель. Если это голосовой ассистент, возможно, вышла модель, которая лучше говорит по-русски. Тогда ваш ассистент на фоне конкурентов будет проигрывать по качеству звука и вызывать у ваших клиентов только лишнее раздражение — они будут знать, что можно сделать лучше. И не только генерация речи: модели генерации текста тоже постоянно становятся умнее. Можно искать что-то более подходящее под конкретный бизнес.
Кроме этого, сам бизнес тоже развивается. Появляются новые сотрудники, новые ниши, новые данные. Всё это требует определённой работы, чтобы ассистент не отставал от реальности и реально приносил пользу, а не просто сидел и работал со старыми и неактуальными данными.
Что такое DevOps и MLOps простыми словами?
Начнём с DevOps. DevOps — это набор практик, который помогает объединить два процесса: процесс разработки (development) и процесс эксплуатации ПО (operations). Любое изменение — от разработчика или, как сегодня бывает, от ИИ-агента — должно попадать в рабочую среду так, чтобы не сломать уже работающую функциональность и чтобы выпуск релиза не занимал много времени. Для этого со временем сложился подход, который называют CI/CD (непрерывная интеграция и доставка): каждое изменение проходит автоматический путь — сборка, тесты, выкладка на тестовый сервер, где его проверяют люди, и только потом на рабочий.
MLOps — это всё то же самое, но для систем машинного обучения. Но здесь к коду добавляются ещё две вещи, которые меняются: данные и модель. Модель обучают на данных и получают веса. Поменялись данные — после переобучения изменилось и поведение модели, даже если код никто не трогал. Поэтому в MLOps версионируют не только код, но и наборы данных и веса. Отслеживают, на каких данных обучена каждая версия модели, и следят, не начали ли реальные данные отличаться от тех, на которых модель училась.
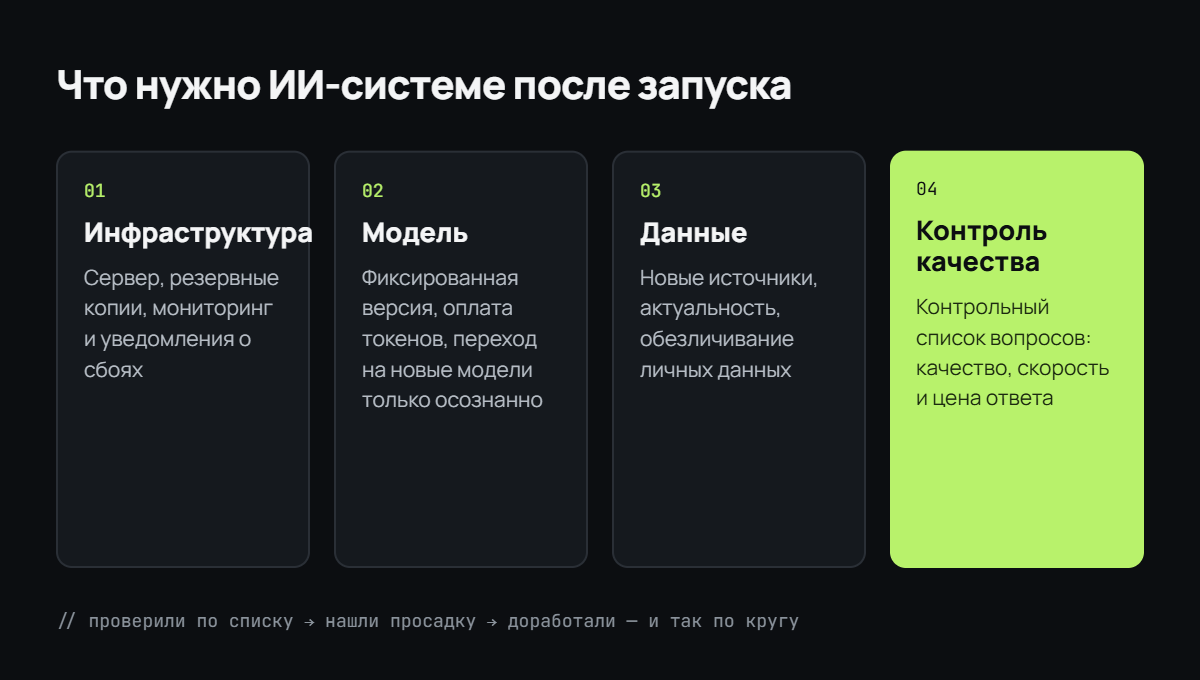
Большинство корпоративных ассистентов берут готовую модель через API и подключают к ней базу знаний компании. Практики для таких систем называют LLMOps, и выглядят они так:
- версии промптов хранятся так же, как код, поэтому любое изменение можно отследить и откатить;
- есть эталонный набор вопросов с правильными ответами, и через него прогоняется каждое изменение: новый промпт, новая версия модели, обновлённая база знаний;
- путь каждого запроса записывается: что спросили, какие документы нашлись, что ответила модель. Так ошибку можно разобрать по шагам, а персональные данные в этих записях маскируются;
- отслеживаются стоимость и скорость ответов, чтобы рост расходов или задержек был виден сразу, а не в конце месяца по счёту.
Почему ИИ отлично работает на демонстрации, а в реальной работе начинает ошибаться?
Интересный вопрос. Это очень сильно зависит от демонстрации. Если подобрать хороший набор тестовых вопросов, то, возможно, удастся ещё на этапе тестирования выявить слабые места, чтобы агент был максимально готов к реальной работе.
Но ответ здесь такой же, как и со всеми системами ещё до эпохи ИИ. На этапе тестирования продукт может хорошо себя показывать, но когда туда попадают реальные люди, они могут найти миллион багов. Людей много, они разные и могут использовать ваш продукт как угодно — вызывать те сценарии, которые невозможно предугадать заранее.
Конечно, перед запуском нужно тестировать максимально. Но после запуска надо быть готовым к тому, что разработчики продолжат исправлять ошибки и улучшать продукт. Написать код сразу без багов невозможно.
Что происходит, когда разработчик нейросети обновляет модель?
Разработчики моделей чаще всего, если меняют что-то критическое, выпускают новую версию модели. При этом старая остаётся в доступе. То есть ломающих изменений в ту же самую версию, как правило, не приходит. Тем не менее провайдеры выводят самые старые модели из эксплуатации по графику, и переход на новую версию становится вынужденным. Одной строчкой в коде переход не ограничивается. Новая модель иначе понимает те же инструкции, иначе оформляет ответы и стоит по-другому. Перед переходом мы прогоняем её по контрольному набору вопросов, при необходимости правим промпты и только потом переключаем.
— Ты рассказывал, что на одном из проектов мы специально выбираем модель с фиксированными весами, чтобы она давала предсказуемый и повторяемый результат. Как это соотносится?
Зависит от ситуации. Если у нас есть разработчик модели, который предоставляет к ней доступ, то ответственность за то, чтобы одна и та же версия вела себя одинаково, лежит на нём — он сам следит за своими весами. Но если мы разрабатываем кастомную модель и размещаем её рядом с нашим продуктом, ответственность уже на нас как на разработчиках. И решается это точно так же, как у разработчиков больших моделей: мы не меняем веса в рамках одной версии модели. Если меняем — выпускаем новую версию и следим за ней.
Про модели с зафиксированными весами и доводку ответов после запуска подробнее — в интервью с Максимом Орловым «Что такое RAG-система простыми словами».
Где лучше разместить корпоративный ИИ: на своих серверах, в российском облаке или у зарубежного провайдера?
Это сложный вопрос, особенно в связи с последними событиями. Универсального ответа нет, всё зависит от задачи.
Если нужно собрать MVP, проверить идею или продукт не предполагает больших расходов на инфраструктуру, можно использовать API — того же ChatGPT и других. Это подходит большому количеству бизнесов. Даже если есть чувствительные персональные данные, можно воспользоваться моделью, размещённой на отечественных серверах, у сервисов, которые сами отвечают за то, чтобы данные оставались внутри России.
Если нужна своя кастомная модель или мы хотим разместить модель у себя, многое зависит от заказчика. Кто-то готов потратить, допустим, 2 миллиона на собственную инфраструктуру: собрать свой сервер, купить две видеокарты RTX 5090 — или три, что уже будет дорого, — плюс оперативная память. Если продукт с точки зрения бизнеса зрелый, люди точно знают, для чего он нужен, и он будет жить долго, то выгоднее заплатить один раз. Собственные мощности надёжнее, гибче в плане контроля и дешевле, если смотреть на горизонт год-два и больше.
Другая ситуация — идея свежая, бизнес в ней не уверен и хочет просто протестировать, но для этого нужна локальная или кастомная модель. Если мы не рассчитываем, что проект проживёт больше нескольких месяцев, конечно, выгоднее арендовать облачное решение за 100–150 тысяч рублей в месяц, чем тратить 2 миллиона на свои серверы.
Зарубежных провайдеров тоже можно использовать, большой разницы нет. Главный вопрос — персональные данные. Если вы обрабатываете персональные данные клиентов, лучше не использовать зарубежные серверы, чтобы не иметь проблем с законом. Если личных или чувствительных данных нет, можно взять и зарубежное облачное решение.
Как защитить данные компании, чтобы они не утекли через нейросеть?
Решения есть разные. Если ресурсов достаточно, можно арендовать или купить собственные мощности, чтобы всё было на своём сервере, — тогда данные точно никуда не уйдут.
Если такой возможности нет, это не беда. Перед отправкой в нейросеть личные данные можно обезличить: адреса, имена, фамилии, номера превратить в абстрактные данные или подменить их на фейковые. Смысл вопроса от этого не поменяется, но личные данные никуда не попадут.
Но прежде всего нужно понимать, какие данные у тебя вообще есть. Часто бывает, что заказчик сам не понимает, что какие-то данные чувствительны к утечке, или не знает, какие данные куда попадают. Поэтому первым шагом должна идти классификация данных. Мы должны точно знать, что и куда передаём.
Из чего складывается стоимость содержания ИИ-системы после запуска?
В первую очередь это инфраструктура. Даже если модель не развёрнута на своих серверах, как минимум потребуется сервер — минимальная отказоустойчивая инфраструктура, чтобы разместить веб-приложение, которое будет отправлять запросы к нейросети.
Дальше — оплата самих токенов, то есть запросов к модели. Она зависит от провайдера. Можно покупать напрямую у OpenAI, но если такой возможности нет, можно воспользоваться российскими поставщиками, которые перепродают токены чуть дороже, но зато расплачиваться можно нашими картами.
И дальше — поддержка. Ассистент — это, в кавычках, «живая вещь»: он требует постоянного развития, если вы хотите, чтобы он работал актуально. Я бы даже делил это на две части. Поддержка — то, что позволяет системе просто оставаться в рабочем состоянии. И развитие — если мы хотим улучшать качество ответов, подключать новые источники данных и так далее.
Хотите заранее понять, сколько будет стоить содержание вашей ИИ-системы? Посчитаем экономику до старта: инфраструктура, токены, поддержка. Оставить заявку →
Как понять, что система начала работать хуже?
Смотрите, как мы делаем приёмку после выполнения работ. Если речь идёт про ассистента, который отвечает на вопросы, можно сформировать контрольный список вопросов. По нему мы понимаем, что система отвечает требованиям из технического задания, и оцениваем качество ответов. Туда же добавляем требуемую скорость ответа, стоимость одного вопроса и, конечно, реальную пользу, которую получают пользователи.
После приёмки у нас на руках есть результат. Если спустя время бизнесу покажется, что ассистент или агент стал работать хуже, можно вернуться к этому списку вопросов и требований и повторно оценить работу системы. Сравниваем с результатом приёмки и сразу видим: либо упало качество, либо система стала дольше отвечать, либо обработка того же вопроса стала стоить дороже.
Оценивать качество нужно комплексно. Часть можно измерить объективно, но всё-таки оценивать качество ответов должны люди.
Кто должен отвечать за ИИ внутри компании после внедрения?
Зависит от договорённостей, вариантов много. Можно вплоть до того, чтобы полностью передать всё заказчику, и он сам будет с этим разбираться.
Но идеальный вариант — когда подрядчик, который занимался разработкой, отвечает за техническую часть и после сдачи, на определённых условиях. А чтобы контролировать работу ассистента или агента со стороны бизнеса, нужен сотрудник со стороны компании, которая внедрила технологию.
Кроме того, если мы интегрируемся с системами клиента, должны быть ответственные и за эти интеграции. Например, если мы интегрируемся с 1С, нужно, чтобы со своей стороны 1С обеспечивала доступность сервиса. Если подключаем сторонний сервис, нужен ответственный — со стороны компании или подрядчика, — который будет общаться с этим третьим лицом.
То есть это смешанная модель: в рамках договорённостей должно быть много разных ответственных. Плохо, когда никто ни за что не отвечает.
Какая была самая неожиданная поломка на ваших проектах и как её решили?
Для заказчиков неожиданным обычно оказывается то, что ломается не нейросеть, а всё вокруг неё. Большая часть работы агента это интеграции: зайти в CRM, учётную систему или календарь и что-то там сделать. Чаще всего отказывают именно они.
Если конкретнее, я уже приводил пример с 1С: для неё часто бывает сложно обеспечить высокую доступность сервиса. Допустим, есть голосовой ассистент, который разговаривает с клиентом в реальном времени. Человек хочет сделать заказ или назначить встречу. Агент это понимает и должен сходить в 1С, посмотреть свободные слоты или наличие товара. Если 1С не отвечает, у агента возникает неприятная пауза. Она может длиться очень долго, и клиент вообще может подумать, что система не работает.
Такие случаи были, и решаются они разными способами. Идеальный — чтобы со стороны 1С сделали нормальный, доступный, надёжный сервис. Но если по какой-то причине это сейчас невозможно, мы со своей стороны можем построить прокси — промежуточное звено между нами и нужным сервисом, которое хранит у себя копию данных. Пока целевой сервис недоступен, все данные хранятся на этой «прокладке». Когда он появляется в сети, данные обновляются и на стороне 1С.
Почему выгрузка данных из 1С — главная проблема при внедрении корпоративного ИИ, подробнее — в интервью с Максимом Орловым.
Какие вопросы собственник должен задать подрядчику, прежде чем заказывать ИИ-систему?
Я считаю, что все вопросы должны решаться совместно. Подрядчик приходит в компанию как сторонний человек, и ответы на вопросы собственника находятся в процессе общения с подрядчиком и его сотрудниками. Я бы даже сказал, что вопросы нужно ставить не столько подрядчику, сколько системе. Потом они попадут в техническое задание как список функциональных и нефункциональных требований.
Что стоит обсудить:
- Критерии приёмки. Это самое главное. Как собственник поймёт, что система доведена до готового состояния и решает бизнес-задачи? Как именно подрядчик вместе с собственником проведут приёмку и проверят качество?
- Негативные сценарии. Что будет, если в системе произойдёт ошибка на каком-то уровне, особенно если система сложная? Такие пограничные случаи нужно обсудить и описать в ТЗ до начала работы, чтобы точно знать, как система поведёт себя в каждом из них.
- Данные. Собственник должен рассказать всё о своих данных. А у подрядчика на основании этого должны появиться вопросы: где будут храниться данные, как они будут обрабатываться и куда уходить. Это связано и с юридическими особенностями, особенно если есть чувствительные данные.
- Ответственные. Кто будет отвечать за что, чтобы система работала. И что произойдёт, если какая-то интеграция, провайдер или любая другая зависимость перестанет работать.
- Стоимость. Стоимость поддержки, обслуживания, тех же токенов. Собственник может сам в этом не разбираться — и он вправе попросить подрядчика посчитать экономику. Например, провести тестовый запуск на ограниченном круге своих клиентов и на реальных данных посчитать, сколько система будет потреблять денег.
Что изменится в этой сфере через 1–2 года?
Здесь два основных сценария, и они абсолютно противоположны.
Первый — развитие. И если это будет развитие, то обязательно экспоненциальное. Те, кто сейчас двигает индустрию, продолжат выпускать более умные модели. Возможно, мы перейдём к новому способу взаимодействия: появятся способы общения ассистентов между собой, менее жёсткие, не прописанные заранее способы обмена данными, и всё это агенты будут решать сами на своей стороне. Для бизнеса вариантов использования будет много. Но это очень сложно предсказать — фантазировать можно сколько угодно.
Второй сценарий — стагнация. Если мы достигли потолка в развитии моделей, то, на самом деле, текущего уровня уже достаточно, чтобы решать очень большое количество задач с помощью ИИ. И мы это активно делаем. Тогда остаётся масштабировать то, что уже есть: запускать больше агентов, искать способы удешевить запросы и токены.
Возможно, станет доступнее запускать свою модель. Постоянно появляются новые способы оптимизации — чтобы для сильной модели нужно было не 32 гигабайта видеопамяти, а, допустим, только 6. Такими темпами рынок может прийти к тому, что у каждого бизнеса будет своя небольшая локальная LLM и каждый будет контролировать свои данные. В любом случае я ожидаю, что доступ к моделям будет становиться проще.
Планируете внедрить ИИ — или уже внедрили и не знаете, что дальше?
Do Digital разрабатывает ИИ-ассистентов, агентов и корпоративные ИИ-системы и сопровождает их после запуска: поддержка, развитие, контроль качества и расходов.